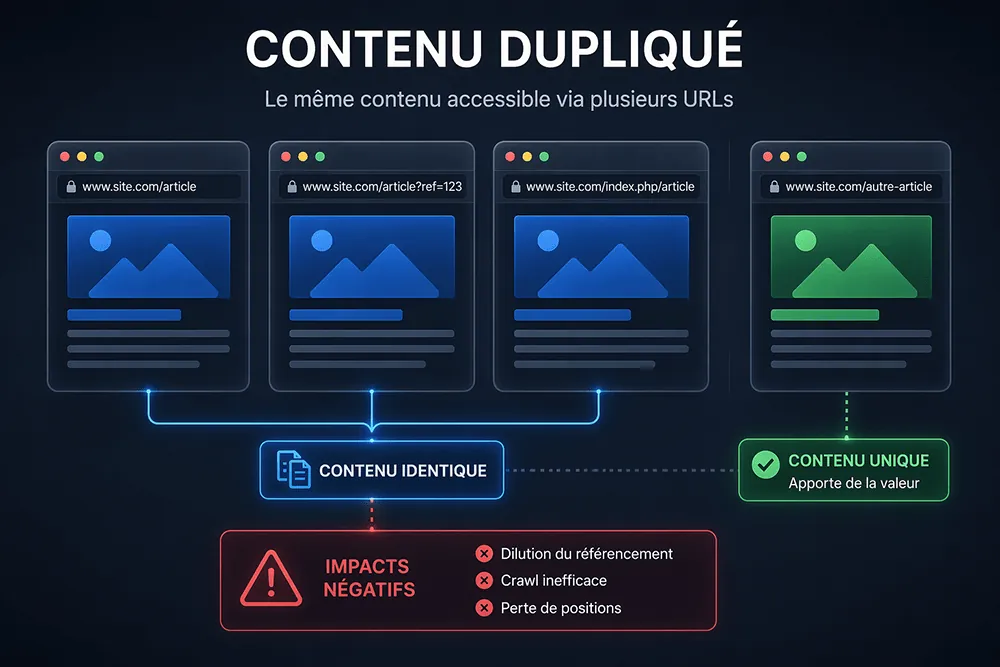
Imaginez que vous passiez des heures à rédiger un article de qualité, à peaufiner chaque mot, à soigner le titre et la balise description — et que Google décide finalement de ne pas l’indexer parce qu’il ressemble trop à une autre page déjà présente sur votre propre site.
Frustrant ? Oui. Courant ?
Terriblement. Le contenu dupliqué en SEO est l’une des erreurs les plus répandues, les moins bien comprises et les plus faciles à éviter quand on sait ce qu’on cherche. Et pourtant, en quelques minutes de lecture de ce guide, vous comprendrez pourquoi le duplicate content ou contenu dupliqué peut nuire sérieusement à votre visibilité dans les résultats de recherche Google.
Que vous soyez rédacteur web, responsable marketing dans une agence parisienne, propriétaire d’un site internet ou professionnel du référencement naturel installé rue de la République ou au bout du monde, ce sujet vous concerne — même si vous n’en avez pas encore conscience.
Car le content ou contenu dupliqué ne se limite pas au copier-coller évident d’un texte plagié depuis un autre site. Il existe des dizaines de causes techniques et éditoriales qui créent de la duplication de contenu présent sur plusieurs pages web à l’insu même des meilleurs rédacteurs — interne ou externe, visible ou non.
Dans ce guide complet, on vous explique tout en français, avec un plan clair et accessible : définition, causes principales du contenu dupliqué sur votre site, outils pour éviter et détecter les doublons, et solutions concrètes — modifier le code, utiliser la balise canonique, réécrire les textes ou opter pour une temps réel reformulation grâce à des outils comme Grammarly.
L’objectif, au meilleur de votre expression SEO Google : faire en sorte que chaque page de votre site web parle d’une seule voix à Google — et qu’éviter le duplicate content devienne un réflexe naturel dans votre stratégie de contenu.
Contenu dupliqué : définition et réalité du problème
Définition du duplicate content en SEO
Le contenu dupliqué — ou duplicate content en anglais — désigne tout contenu d’une page web qui apparaît à l’identique ou de manière très similaire sur plusieurs URL différentes, qu’il s’agisse de pages issues du même site (contenu dupliqué interne) ou de sites web différents (contenu dupliqué externe).
En SEO, on parle de contenu dupliqué dès lors que deux pages ou plus présentent un contenu identique ou suffisamment similaire pour que les moteurs de recherche peinent à déterminer laquelle doit être considérée comme la source originale et laquelle doit être indexée en priorité.
La définition officielle utilisée par Google est délibérément large : il n’est pas nécessaire que le texte soit copié mot pour mot pour être considéré comme dupliqué. Un contenu similaire à plus de 70-80%, des descriptions produits quasi identiques, ou un même article publié sur plusieurs URL différentes constituent autant de cas de duplicate content aux yeux du moteur de recherche.
Contenu dupliqué interne vs contenu dupliqué externe
Il est essentiel de distinguer les deux grands types de contenu dupliqué, car leurs causes et leurs solutions sont différentes.
Le contenu dupliqué interne — ou duplicate content interne — se produit au sein d’un même site web : plusieurs pages web du propre site internet présentent un contenu identique ou très similaire. C’est le type de contenu dupliqué sur votre site le plus courant et souvent le plus facile à corriger, mais aussi le plus difficile à rechercher sans outil dédié.
Un exemple réel : une fiche produit accessible à la fois via /categorie-a/produit et /categorie-b/produit — deux URL différentes pour le même contenu, ce qui dilue directement la position de cette page dans les résultats de recherche.
Le contenu dupliqué externe se produit entre deux sites web différents. Soit votre contenu original a été copié-collé par un tiers sans autorisation (vol de contenu), soit vous avez publié le même contenu sur plusieurs domaines différents (syndication sans précaution).
Dans ce dernier cas, si la balise canonique n’est pas correctement utilisée, Google peut indexer la version copiée plutôt que votre contenu original — ce qui est particulièrement pénalisant pour votre stratégie de référencement.
La différence entre contenu identique et contenu similaire
Tous les cas de duplicate content ne se valent pas. On distingue généralement le contenu strictement identique — du copier-coller pur, mot pour mot — et le contenu similaire, qui partage une grande partie de sa structure, de ses formulations ou de ses informations sans être rigoureusement identique.
Du point de vue du moteur de recherche, les deux posent problème, mais à des degrés différents. Le contenu strictement identique est traité directement comme du duplicate content par l’algorithme de Google. Le contenu similaire est une zone plus grise, mais il peut tout de même nuire à votre référencement naturel si les pages en question se retrouvent en concurrence sur les mêmes requêtes.
La reformulation et la réécriture sont les solutions éditoriales privilégiées dans ce second cas.
Le mythe de la pénalité Google — ce que Google pénalise vraiment
Une idée reçue très répandue mérite d’être corrigée : Google ne pénalise pas automatiquement le contenu dupliqué. Il le gère. Concrètement, quand Google détecte plusieurs pages avec un contenu identique ou très similaire, il choisit l’une d’elles comme version principale à indexer et à afficher dans les résultats de recherche — et il ignore ou déprioritise les autres.
Ce n’est pas une pénalité au sens strict (contrairement aux sanctions manuelles appliquées en cas de contenu manifestement trompeur ou de spam). Mais l’effet est tout aussi néfaste : vos pages ne sont pas indexées, votre autorité de domaine est diluée, votre budget de crawl est gaspillé et votre trafic organique s’en ressent directement.
Google pénalise en revanche clairement le contenu plagié de mauvaise foi — du contenu copié-collé délibérément pour tromper les moteurs de recherche.
Les causes du contenu dupliqué
Les problématiques techniques : les causes les plus sournoises
Les causes techniques du contenu dupliqué sont les plus difficiles à identifier car elles ne sont pas toujours visibles à l’œil nu. Pourtant, elles représentent la majorité des cas de duplicate content rencontrés lors d’un audit SEO.
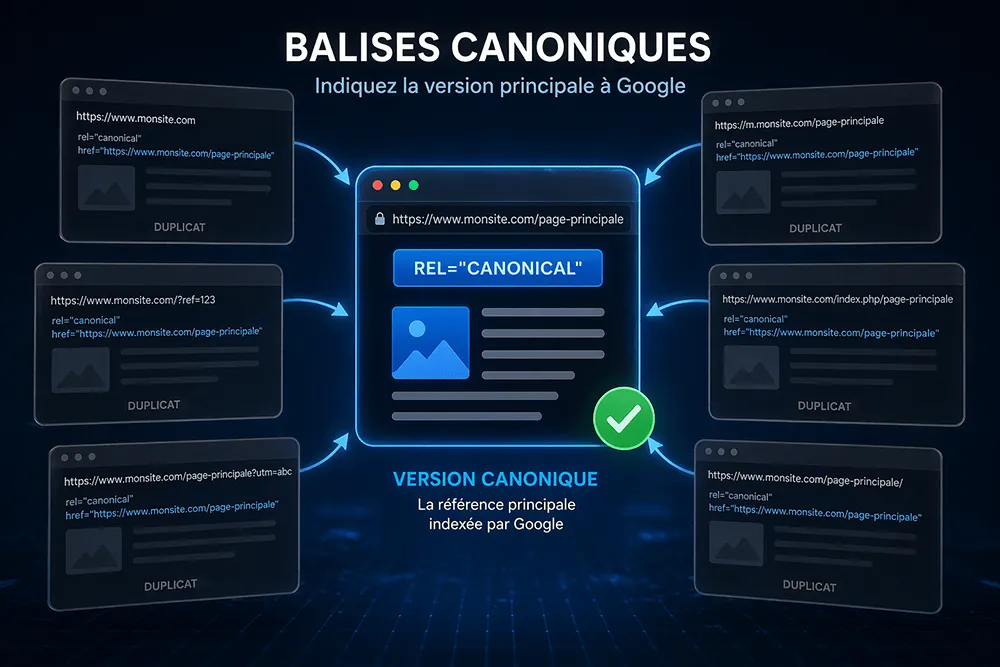
Les variantes d’URL sont la première cause technique de duplication. Un même contenu peut être accessible via http://monsite.com, https://monsite.com, http://www.monsite.com et https://www.monsite.com — soit quatre URL différentes pour une seule page. Sans redirection 301 correctement configurée et sans balise canonique, Google peut indexer plusieurs de ces versions simultanément, créant du contenu dupliqué interne à votre insu.
Les paramètres d’URL constituent une autre source majeure de duplication. Sur les sites e-commerce notamment, les filtres de navigation (couleur, taille, prix), les paramètres de session utilisateur et les tags de tracking ajoutent des paramètres à l’URL — générant potentiellement des centaines ou des milliers de variantes d’URL pour un même contenu. Chaque URL unique est une nouvelle page aux yeux du crawler de Google.
La version mobile du site, quand elle est hébergée sur un sous-domaine séparé (m.monsite.com), crée du contenu dupliqué entre la version desktop et la version mobile. Ce problème est aujourd’hui moins fréquent grâce au responsive design, mais il existe encore sur de nombreux sites anciens.
La pagination mal gérée est également une cause courante : les premières entrées d’une liste d’articles ou de produits apparaissent sur plusieurs pages paginées avec des URL différentes, créant de la duplication sur les premières lignes de contenu de chaque page.
Les causes éditoriales : quand la duplication vient du contenu lui-même
Au-delà des problèmes techniques, la duplication de contenu peut avoir des causes purement éditoriales. Ces cas sont souvent plus simples à identifier mais demandent un travail de rédaction web pour être résolus.
Les fiches produit identiques ou très similaires sont le cas le plus fréquent en e-commerce. Quand un site propose des produits déclinés en plusieurs variantes (coloris, tailles, capacités), chaque variante a souvent sa propre URL avec une fiche quasi identique à la précédente.
Sans gestion canonique ou sans effort de différenciation éditoriale, ces pages se font concurrence dans les résultats de recherche.
Les descriptions produit reprises directement du fabricant ou du fournisseur sont une autre cause classique. Des dizaines de sites e-commerce utilisent exactement les mêmes descriptions — ce qui crée du contenu dupliqué externe à grande échelle. Pour se démarquer, chaque site doit produire ses propres descriptions, avec sa propre ligne éditoriale et sa propre valeur ajoutée.
Le copier-coller entre pages d’un même site — une introduction reprise à l’identique sur plusieurs articles du blog, un texte de présentation copié d’une page à l’autre — génère du contenu dupliqué interne parfois difficile à détecter sans outil dédié.
Les causes liées à la présence multi-plateforme
La présence d’une marque ou d’un professionnel sur plusieurs plateformes crée fréquemment du contenu dupliqué externe, souvent de bonne foi et sans mauvaise intention.
Publier un article sur son site web, puis le republier intégralement sur LinkedIn, Facebook ou Twitter sans précaution est une pratique courante — mais elle peut être problématique si Google indexe la version publiée sur le réseau social avant la version originale sur votre site.
La solution : partager un extrait ou un résumé sur les réseaux sociaux, avec un lien vers l’article original, plutôt que de republier le texte en entier.
La syndication de contenu — publier un même article sur son site et sur des sites partenaires — est une pratique légitime dans le cadre d’une stratégie d’inbound marketing. Mais elle nécessite l’utilisation systématique de la balise canonique sur la version syndiquée, pour indiquer aux moteurs de recherche que la version originale se trouve sur votre propre site web.
Pensez également à optimiser chaque version publiée sur un média partenaire : une citation claire de la source originale, une réduction du texte par rapport à la version complète, ou un lien rel=canonical sont autant de bonnes pratiques pour éviter le duplicate content externe tout en bénéficiant de la portée du partenaire.
Sans cette précaution, vous risquez de voir votre contenu indexé en priorité chez votre partenaire plutôt que sur votre domaine.
Le vol de contenu est une réalité sur internet. Certains sites copient-collent du contenu original depuis d’autres sources sans autorisation ni citation. C’est un cas de contenu plagié que vous ne contrôlez pas directement — mais que vous pouvez surveiller et signaler à Google via le système DMCA.
L'impact du contenu dupliqué sur votre référencement
Impact sur l'indexation : Google doit choisir
Le premier effet du contenu dupliqué sur votre SEO est un problème d’indexation. Quand Google crawle votre site web et trouve plusieurs pages avec un contenu identique ou très similaire, il doit choisir laquelle indexer comme version principale — et laquelle ignorer ou déprioritiser dans les résultats de recherche.
Ce choix n’est pas toujours celui que vous auriez fait. Google peut sélectionner une URL avec des paramètres techniques peu favorables (http au lieu de https, URL longue et peu lisible, version mobile au lieu de la version desktop) plutôt que la version que vous considérez comme principale.
Et une fois ce choix fait, il peut être difficile à modifier sans intervention technique explicite — via une balise canonique ou une redirection 301.
Dilution de l'autorité et du link juice
Le contenu dupliqué dilue l’autorité de votre site web. Si plusieurs pages avec un contenu identique ou similaire reçoivent des liens entrants (backlinks), le link juice est réparti entre toutes ces pages plutôt que d’être concentré sur une seule URL.
Résultat : aucune de ces pages ne bénéficie de toute l’autorité qu’elle aurait pu accumuler si le contenu avait été unique et consolidé sur une seule URL.
C’est particulièrement problématique pour les pages stratégiques — pages produit, articles de blog clés, pages de service — dont le positionnement dans les résultats de recherche dépend directement de leur autorité relative. La présence de contenu dupliqué peut ainsi nuire considérablement à votre stratégie SEO sans que vous en compreniez immédiatement la raison.
Gaspillage du budget de crawl
Le budget de crawl est la ressource limitée qu’alloue Google à l’exploration de votre site web lors de chaque passage de son robot. Si ce budget est gaspillé sur des URL dupliquées — des pages sans valeur ajoutée réelle qui reprennent un contenu déjà indexé ailleurs — vos pages importantes risquent de ne pas être crawlées assez fréquemment, voire de ne pas l’être du tout.
Pour les grands sites avec des milliers de pages, la gestion du budget de crawl est un enjeu SEO majeur. Réduire le contenu dupliqué est l’une des actions les plus efficaces pour libérer du budget de crawl et le concentrer sur les pages qui méritent d’être explorées et indexées en priorité.
Impact sur l'expérience utilisateur
Au-delà de l’impact purement technique sur le référencement, le contenu dupliqué a un effet négatif sur l’expérience utilisateur. Un internaute qui tombe sur deux pages quasi identiques depuis les résultats de recherche Google se retrouve dans une situation confuse : laquelle lire ?
Laquelle partager ? Laquelle citer ? Cette confusion nuit à la crédibilité de votre site et à la qualité de la communication avec vos visiteurs.
Un site web qui produit du contenu unique, original et bien structuré inspire la confiance — tant aux yeux des utilisateurs qu’aux yeux des moteurs de recherche. C’est la base de toute stratégie de référencement naturel durable et efficace.
Comment détecter le contenu dupliqué
Screaming Frog — L'outil de référence pour l'audit interne
Screaming Frog est sans doute le meilleur outil disponible pour détecter le contenu dupliqué interne sur un site web. Ce crawler de bureau analyse l’intégralité des URL de votre site et identifie les pages dont le contenu est identique ou similaire — en se basant sur les balises title, les meta descriptions, les en-têtes H1, mais aussi sur le contenu textuel des pages.
Son rapport sur le contenu dupliqué permet de voir en un coup d’œil quelles pages sont en double, quelles URL sont concernées et quel est le niveau de similarité entre elles. Indispensable pour tout audit SEO sérieux, Screaming Frog est disponible en version gratuite (jusqu’à 500 URL) et en version payante pour les sites plus importants.
Siteliner — Détecter le contenu en double sur votre propre site
Siteliner est un outil en ligne gratuit spécialisé dans la détection du contenu dupliqué intra-site. Il crawle votre site web et identifie les pages qui partagent du contenu commun, en calculant un pourcentage de similarité pour chaque paire de pages concernées.
Son interface simple et ses rapports visuels en font un outil particulièrement utile pour un premier diagnostic rapide, sans avoir besoin d’installer un logiciel.
Siteliner identifie également les pages avec un contenu trop pauvre ou trop court — un autre facteur négatif pour le référencement naturel. Pour une analyse complète de votre site web, il constitue un complément précieux à Screaming Frog.
Copyscape — Vérifier si votre contenu a été copié
Copyscape est l’outil de référence pour détecter le contenu dupliqué externe — c’est-à-dire vérifier si votre contenu original a été copié-collé sur d’autres sites web sans votre autorisation. Entrez l’URL d’une page de votre site, et Copyscape recherche sur internet des pages avec un contenu identique ou similaire.
En version gratuite, les fonctionnalités sont limitées ; la version payante offre des recherches illimitées et des alertes automatiques en temps réel quand un nouveau doublon est détecté.
Pour un rédacteur web, un auteur ou un professionnel dont le contenu est régulièrement republié sans mention de la source, Copyscape est un outil indispensable pour surveiller le contenu dupliqué et agir rapidement en cas de vol de contenu.
Duplichecker et autres outils gratuits
Duplichecker est un outil gratuit de vérification du plagiat, utile pour analyser rapidement un texte et vérifier s’il existe des versions identiques ou similaires sur internet. Son utilisation est simple : collez votre texte ou entrez une URL, et l’outil analyse le contenu en quelques secondes. Sa version gratuite est suffisante pour des vérifications ponctuelles.
Kill Duplicate est un autre outil spécialisé dans la détection et la gestion du contenu dupliqué, particulièrement utilisé par les agences SEO et les professionnels du référencement. Il permet d’identifier en quelques minutes les doublons présents sur votre site web et de prioriser les corrections à apporter.
Google Search Console — La vision du moteur de recherche
Google Search Console est un outil gratuit fourni par Google qui donne accès à la vision réelle du moteur de recherche sur votre site web. Son rapport de couverture indique les pages indexées, les pages exclues et les raisons de ces exclusions — parmi lesquelles figurent souvent des problèmes de contenu dupliqué (page en double, URL canonique signalée par Google comme différente de celle que vous avez indiquée, etc.).
L’outil de recherche Google lui-même peut également être utilisé manuellement pour détecter le contenu dupliqué : tapez un extrait de texte de votre page entre guillemets dans la barre de recherche Google, et vérifiez si d’autres pages avec le même contenu apparaissent dans les résultats. Cette technique simple et gratuite est souvent la première étape d’un audit de contenu dupliqué.
Les solutions pour éviter et gérer le contenu dupliqué
La balise canonique — Indiquer la version principale à Google
La balise canonique (balise rel canonical ou tag canonique) est la solution technique la plus utilisée et la plus efficace pour gérer le contenu dupliqué. Elle consiste à ajouter dans le code HTML d’une page une balise qui indique aux moteurs de recherche quelle est la version principale — la page originale — parmi plusieurs pages avec un contenu identique ou similaire.
Sa syntaxe dans le code HTML est la suivante :
<link rel="canonical" href="https://www.votresite.com/page-originale/" />Placée dans la section <head> de la page dupliquée, cette balise dit à Google : « je sais que cette page ressemble à une autre, mais c’est cette URL qui est la version de référence — c’est elle que tu dois indexer et à qui tu dois attribuer l’autorité SEO ». La balise canonique est le recours privilégié pour gérer les variantes d’URL, les pages accessibles via plusieurs chemins, et les contenus syndiqués sur des sites partenaires.
Les redirections 301 — Unifier les URL
La redirection 301 est la solution technique à privilégier quand une URL dupliquée doit être définitivement supprimée ou fusionnée avec une autre. Elle redirige automatiquement les utilisateurs et les robots vers l’URL de destination, et transfère l’essentiel de l’autorité SEO accumulée par l’ancienne URL vers la nouvelle.
La redirection 301 est particulièrement adaptée pour résoudre les problèmes de variantes de protocole (http vs https), de sous-domaine (www vs non-www), et d’URL similaires issues d’une migration ou d’une restructuration du site web. C’est une solution radicale et efficace, mais elle nécessite de modifier le code — voire modifier modifier le code serveur selon les environnements — une intervention qui requiert des compétences techniques ou l’aide d’un professionnel.
Si vous cherchez des outils pour éviter d’avoir à intervenir manuellement, certains plugins CMS comme Yoast SEO ou Rank Math intègrent des fonctionnalités de gestion des redirections sans nécessiter de modification directe du code. Une modification bien documentée dans un plan de suivi évite aussi les erreurs de régression lors des mises à jour.
La balise noindex — Exclure les pages non stratégiques
La balise noindex est une directive qui indique aux moteurs de recherche de ne pas indexer une page spécifique. Contrairement à la balise canonique qui transfère l’autorité vers une autre URL, la balise noindex exclut simplement la page de l’index Google sans transférer de valeur SEO.
Cette solution est adaptée pour les pages qui ont peu de valeur éditoriale et qui ne méritent pas d’être indexées — pages de résultats de recherche interne, pages de filtres et de tris, pages de conditions d’utilisation et de politique de confidentialité, pages de tags et d’archives de blog.
En réduisant le nombre de pages indexées inutilement, vous concentrez le budget de crawl de Google sur vos pages stratégiques et améliorez la qualité globale de votre présence dans les résultats de recherche.
Créer du contenu unique et original — La solution éditoriale
La meilleure façon d’éviter le contenu dupliqué reste de créer du contenu unique et à valeur ajoutée dès le départ. Pour les sites e-commerce, cela signifie rédiger des descriptions produit originales plutôt que de reprendre celles du fabricant — en adoptant son propre style, sa propre ligne éditoriale et ses propres arguments commerciaux.
Pour les blogs et les sites de contenu, cela implique de produire des articles originaux, bien documentés et différents de ce qui existe déjà sur internet.
La rédaction web de qualité est un investissement, pas une dépense. Un contenu unique bien rédigé se positionne mieux dans les résultats de recherche, génère plus de trafic organique et inspire davantage confiance aux utilisateurs qu’un contenu générique ou copié.
Faire appel à un rédacteur web professionnel ou à une agence SEO spécialisée en création de contenu peut s’avérer particulièrement utile pour les sites qui ont besoin de produire du contenu en volume sans sacrifier la qualité.
La réécriture et la reformulation — Quand le contenu existant doit évoluer
Quand du contenu dupliqué existe déjà sur votre site web et qu’il n’est pas possible de le supprimer (pages produit indispensables, pages de service similaires), la réécriture et la reformulation sont les solutions éditoriales à privilégier. L’objectif est de différencier suffisamment les pages pour qu’elles ne soient plus considérées comme dupliquées par Google — en ajoutant du contenu unique, en modifiant la structure, en enrichissant les informations spécifiques à chaque page.
Des outils comme Grammarly peuvent aider à identifier les formulations trop proches et à suggérer des alternatives en utilisant des techniques de réécriture assistée — mais réécrire en profondeur un contenu reste un travail humain qui demande du temps et une bonne maîtrise de la rédaction web.
En utilisant une approche de temps réel reformulation, certains rédacteurs s’appuient sur des outils d’IA pour accélérer la réécriture de leurs contenus dupliqués, avant de retravailler le résultat manuellement pour en assurer la qualité et l’originalité. La date de publication mise à jour et visible sur chaque article ou page peut également aider Google à identifier la version originale d’un contenu dans le temps.
Surveiller le contenu dupliqué dans la durée
Gérer le contenu dupliqué n’est pas une action ponctuelle — c’est un suivi régulier à intégrer dans sa stratégie SEO. Plusieurs pratiques permettent de surveiller le contenu dupliqué dans le temps : programmer des crawls réguliers avec Screaming Frog ou Siteliner, configurer des alertes Copyscape pour être notifié en temps réel quand votre contenu est copié sur un autre site, et consulter régulièrement les rapports Google Search Console pour détecter de nouveaux problèmes d’indexation liés à la duplication.
Une politique de contenu claire — qui définit les règles de publication, de syndication et d’utilisation du contenu au sein de votre entreprise et avec vos partenaires — est également un levier utile pour prévenir la création de contenu dupliqué à la source.
Web Opteam : votre agence SEO pour auditer et corriger le contenu dupliqué
L'audit SEO : détecter ce que vous ne voyez pas
Chez Web Opteam, l’audit du contenu dupliqué fait partie intégrante de tout audit SEO technique. Notre approche consiste à crawler l’intégralité de votre site web pour identifier toutes les sources de duplication — variantes d’URL, paramètres techniques, pages similaires, contenus syndiqués non balisés — et à produire un rapport priorisé avec des recommandations concrètes et actionnables.
Que vous soyez une entreprise avec un petit site vitrine ou un e-commerce avec des milliers de fiches produit, notre équipe d’experts SEO sait identifier les problèmes de contenu dupliqué qui nuisent à votre référencement et vous proposer les solutions les plus adaptées à votre situation.
Accompagnement technique et éditorial
Notre accompagnement va au-delà du diagnostic. Web Opteam vous aide à mettre en oeuvre les corrections techniques — configuration des balises canoniques, des redirections 301, des directives noindex, des paramètres d’URL dans Google Search Console — et vous accompagne dans la stratégie éditoriale pour créer du contenu unique et de qualité sur le long terme.
Nous travaillons en étroite collaboration avec vos équipes de rédaction, vos développeurs et vos responsables marketing pour assurer une gestion cohérente du contenu sur l’ensemble de votre site web et de vos plateformes de communication — réseaux sociaux, blog, site partenaire.
Formation et montée en compétences
Web Opteam propose des formations SEO dédiées à la rédaction web et à la stratégie de contenu, qui incluent un volet complet sur le contenu dupliqué : comment l’identifier, comment l’éviter dès la phase de création, et comment utiliser les bons outils pour le surveiller dans le temps.
Ces formations sont disponibles en présentiel ou à distance, et sont adaptées à tous les niveaux — du débutant au professionnel du marketing digital déjà expérimenté.
Pour en savoir plus sur notre offre d’accompagnement SEO et nos formations, contactez directement notre équipe — on est là pour vous aider à faire du contenu unique votre meilleur allié dans les résultats de recherche Google.
Le contenu dupliqué, c'est un problème qui se règle — à condition de le voir
En conclusion, le duplicate content n’est pas une fatalité. C’est un problème technique et éditorial qui se détecte, se corrige et s’évite avec les bons outils et les bonnes pratiques. Balise canonique, redirections 301, noindex, réécriture, surveillance régulière : les solutions existent et sont à la portée de tout professionnel du référencement naturel — ou de toute agence SEO sérieuse.
Le vrai risque, c’est de ne rien faire. Laisser du contenu dupliqué s’accumuler sur votre site web, c’est laisser Google faire des choix à votre place — et pas forcément les bons. C’est diluer votre autorité, gaspiller votre budget de crawl et offrir à vos concurrents une longueur d’avance qu’ils n’auraient pas méritée.
Alors, prêt à auditer votre site ? Commencez par un crawl Screaming Frog, une analyse Siteliner et une vérification Copyscape — et vous aurez déjà une idée claire de l’ampleur du chantier. Et si vous avez besoin d’un coup de main, l’équipe Web Opteam est là — avec les outils, l’expertise et l’envie sincère de faire briller votre contenu dans les résultats de recherche Google.